
PowerGres にはベクトル類似度検索のための拡張モジュール pgvector が付属しており、セットアップするだけで利用できます。pgvector は機械学習やAI分野で使用されるベクトルデータ型とベクトル間の類似度検索機能を提供します。
本記事では、pgvector のセットアップから基本的な使い方、そして機械学習(FastText)で作成された二百万件の日本語ベクトルデータを実際に検索する例までを紹介します。
ベクトルデータはいくつかの数値の組として成り立つデータのことです。
ベクトルとはもともとは数学の概念で、例えば2つ組(x, y) の数値だけで構成されるベクトルは2次元ベクトルといい、ベクトルデータとして(2, 1)、(1, 4)などが考えられます。ベクトルデータを図示する場合は矢印として表現することが一般的です。
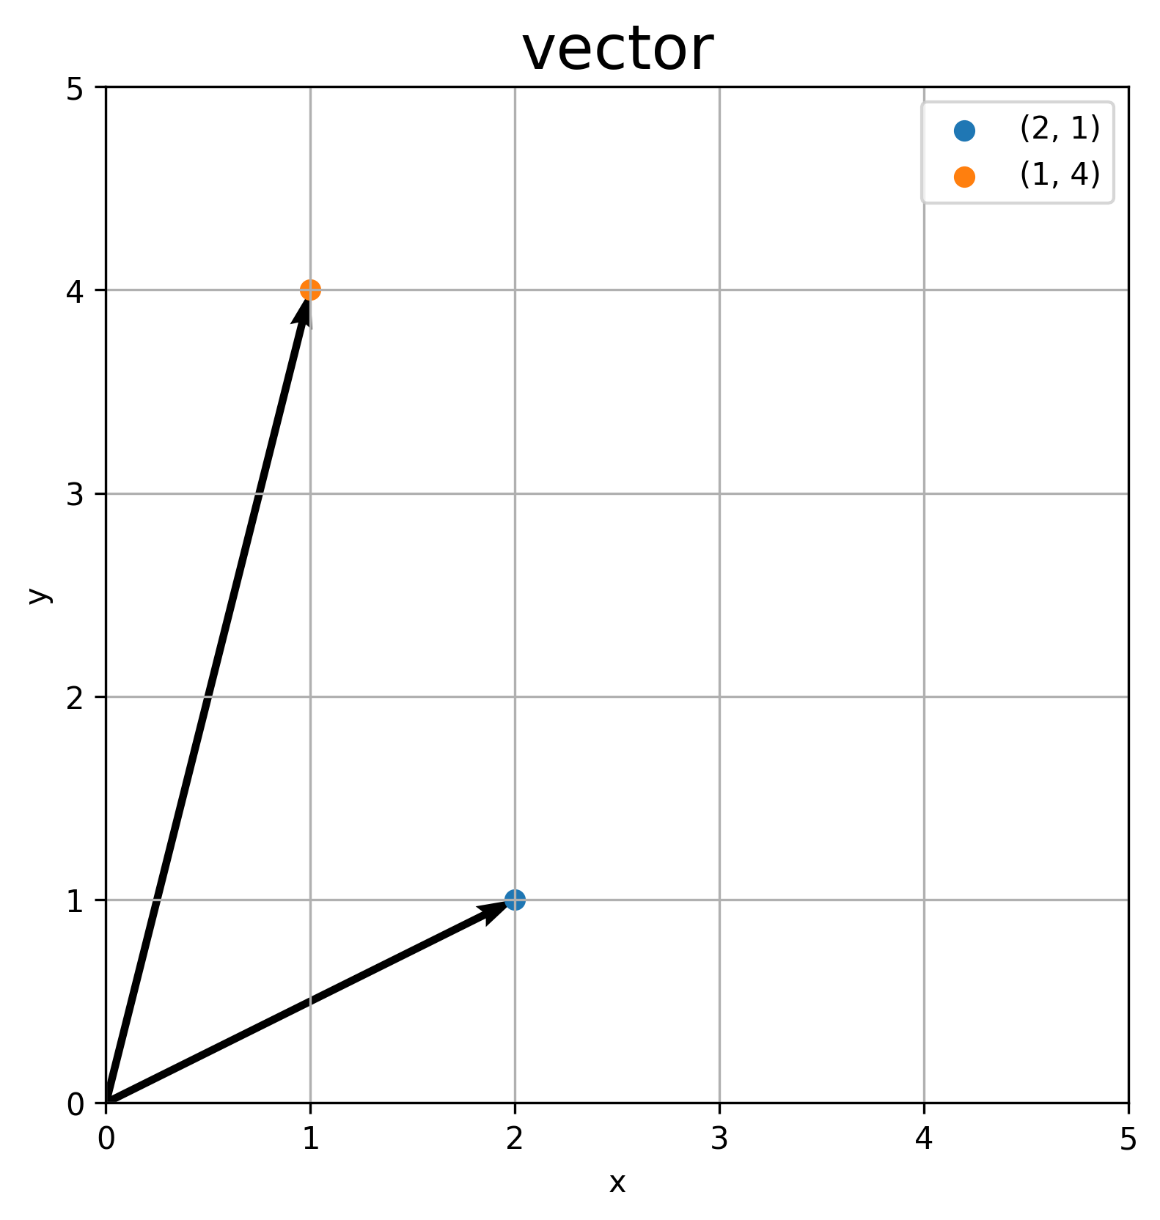
また、3つ組の数値からなる、3次元のベクトル(8, -4, 40)や、整数だけでなく、例えば小数を要素に含む(9.5403, 0.4, 788) もベクトルデータです。pgvector は最大で16000組の数値からなる16000次元まで扱うことができます。
ベクトルデータ同士の加算、内積などの演算や、ベクトルデータ間の色々な距離が定義されています。
pgvector はベクトルデータの保存と各種演算、距離の測定など、数学のベクトルで定義されているものが利用できます。
PowerGres をinstall.sh でインストールした場合、pgvector もインストール済みです。管理ユーザでデータベースに接続して、「CREATE EXTENSION vector;」を実行するだけで利用できます。
[postgres@rocky9 ~]$ /opt/powergres17/bin/psql -U postgres -d testdb
psql (17.9)
Type "help" for help.

testdb=# \dx
                 List of installed extensions
  Name   | Version |   Schema   |         Description
---------+---------+------------+------------------------------
 plpgsql | 1.0     | pg_catalog | PL/pgSQL procedural language
(1 row)

testdb=# CREATE EXTENSION vector;
CREATE EXTENSION
testdb=# \dx
                             List of installed extensions
  Name   | Version |   Schema   |                     Description
---------+---------+------------+------------------------------------------------------
 plpgsql | 1.0     | pg_catalog | PL/pgSQL procedural language
 vector  | 0.8.1   | public     | vector data type and ivfflat and hnsw access methods
(2 rows)

testdb=# \q
これでpgvector のセットアップは終了です。
まずはベクトルデータ型を持つテーブルを定義します。
CREATE TABLE items (id bigserial PRIMARY KEY, vec vector(3));
items テーブルのvec 項目を3次元のvector型で定義しています。
vector型の各要素はPowerGres のreal型と同様の単精度浮動小数点数で格納されます。
次にテーブルにINSERT でデータを作成します。
INSERT INTO items VALUES(1, '[1.0, 0.0, 0.0]');
vector型は[要素1,要素2,…]といった典型的な配列を表す文字列定数で入力できます。他にはARRAYキーワードを使った配列で入力する方法もあります。
CREATE、INSERTの実行結果です。
[postgres@rocky9 ~]$ psql -U testuser -d testdb
psql (17.9)
Type "help" for help.

testdb=> SET search_path = testschema, public;
SET
testdb=> CREATE TABLE items (id bigserial PRIMARY KEY, vec vector(3));
CREATE TABLE
testdb=> INSERT INTO items VALUES(1, '[1.0, 0.0, 0.0]');
INSERT 0 1
testdb=> INSERT INTO items VALUES(2, '[0.0, 1.0, 1.0]');
INSERT 0 1
testdb=> INSERT INTO items VALUES(3, '[2.0, 2.0, 1.0]');
INSERT 0 1
testdb=> INSERT INTO items VALUES(4, '[1.0, 5.0, 1.0]');
INSERT 0 1
testdb=> INSERT INTO items VALUES(5, '[0.0, 2.0, 0.0]');
INSERT 0 1
testdb=>
ここでは5つのベクトルデータのレコードをINSERTしています。
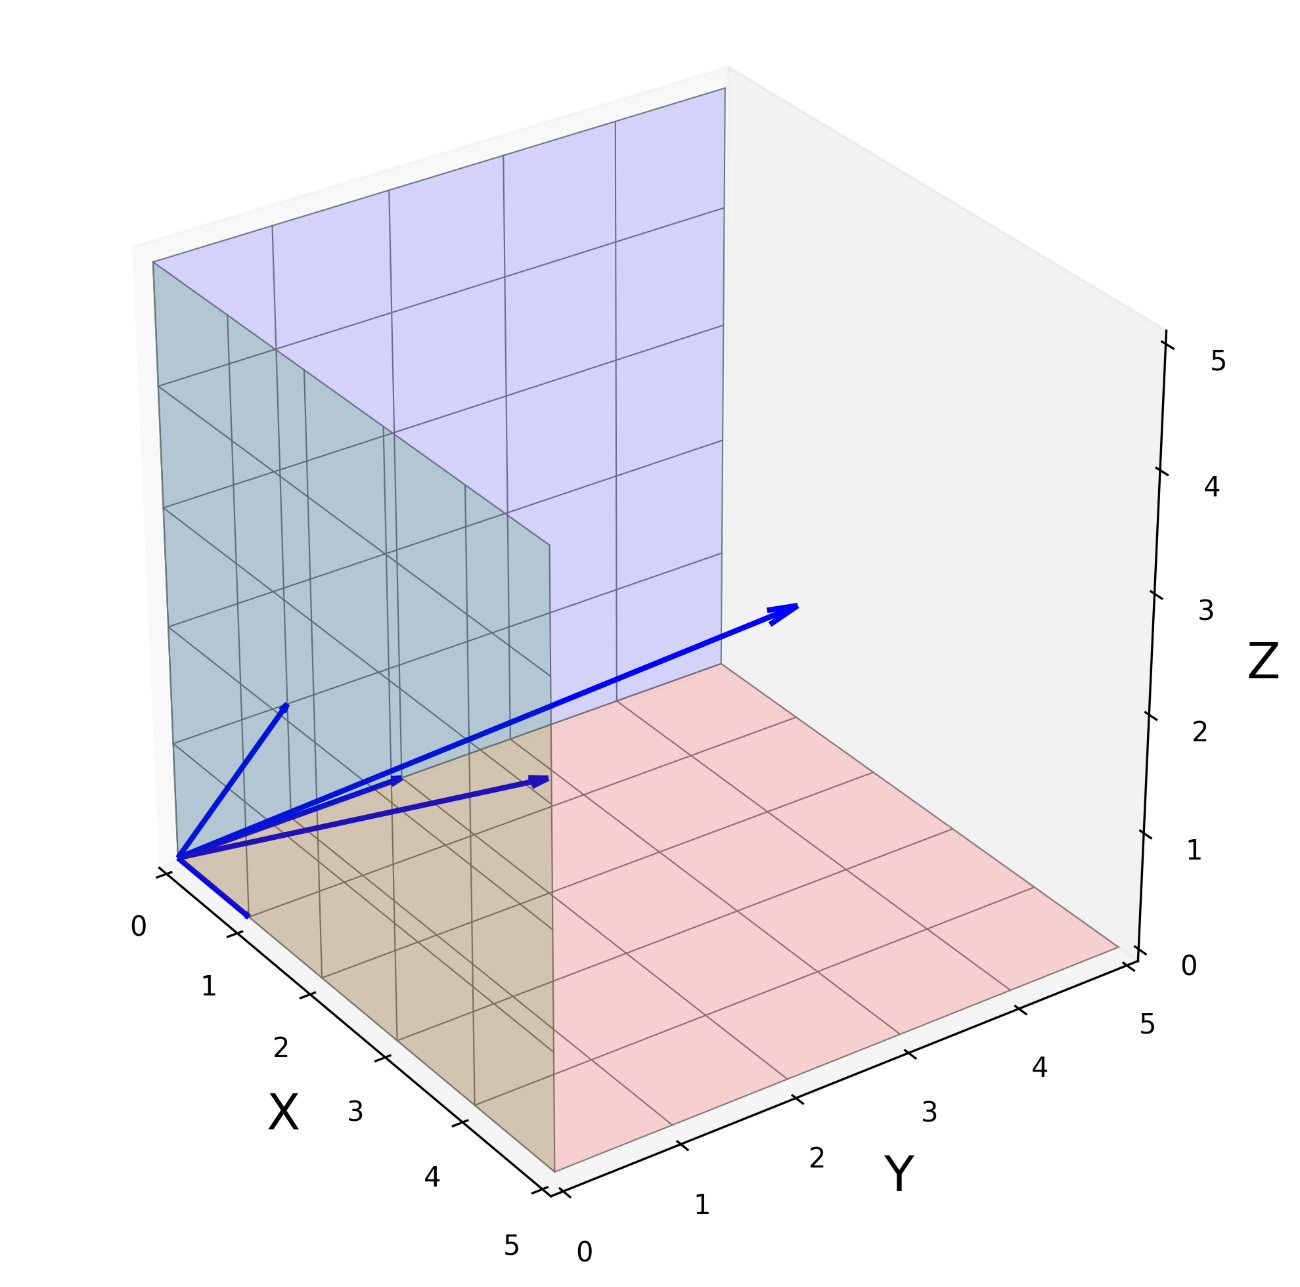
3次元ベクトルデータが入っているvec 項目を図で表すと下記になります。
(1番目の要素をX軸、2番目の要素をY軸、3番目の要素をZ軸で表示しています。)
次に登録したデータを検索します。ソート順はvec 項目の1番目の要素の昇順を指定します。
testdb=> SELECT * FROM items ORDER BY (vec::float4[])[1];
 id |   vec
----+---------
  2 | [0,1,1]
  5 | [0,2,0]
  1 | [1,0,0]
  4 | [1,5,1]
  3 | [2,2,1]
(5 rows)

testdb=>
ベクトルデータの要素は、1スタートなので[1]と指定しています。
次に3次元ベクトル空間の原点(=[0, 0, 0])に距離が近い順にソートします。
testdb=> SELECT * FROM items ORDER BY vec  '[0, 0, 0]';
 id |   vec
----+---------
  1 | [1,0,0]
  2 | [0,1,1]
  5 | [0,2,0]
  3 | [2,2,1]
  4 | [1,5,1]
(5 rows)

testdb=>
「」演算子で指定しています。これは2つのベクトルのユークリッド距離を計測する演算子です。ユークリッド距離とは点と点との直線距離のことです。
pgvector はユークリッド距離の他にも、コサイン距離、マンハッタン距離も使用できます。
また、ベクトルの加法も使用できるためSUMなども実行できます。
testdb=> SELECT SUM(vec) FROM items;
   sum
----------
 [4,10,3]
(1 row)

testdb=>
このように、ベクトルで定義された演算が使用できるためpgvector はAIアプリケーションとの親和性があります。
AIアプリケーションでは、文章、画像、音声などを扱いやすいベクトルデータに変換して保存します。この変換をエンベディング(Embedding)と呼び、変換されたベクトル同士を比較することで、データ間の類似関係を計算できます。
AIアプリケーションではデータ間の類似関係を扱う必要があります。例えばこの画像は犬より猫に似ているとか、この音声はこの人物の声に一番近いなどを計算します。
類似関係を計算するのにベクトルが使われています。
エンベディングする方法の例として、単語をベクトルデータに変換する方法があります。
例えば「サッカーボール」「パンダ」「柴犬」という三つの単語の類似関係を考えてみます。
大きさだと「サッカーボール」と「柴犬」は似ているので近く、それに比べて「パンダ」は大きいので遠くなります。色だと「サッカーボール」と「パンダ」は白黒で似ているので近く、「柴犬」は遠くなります。毛の有無だと「柴犬」と「パンダ」は毛が生えているので近く、「サッカーボール」は遠くなります。
大きさ、色、毛の有無からなる3次元のベクトル空間を考え、次元ごとに近ければ近い(=差が小さい)数値を、遠ければ遠い数値を割り当てることで、「サッカーボール」「柴犬」「パンダ」という単語をベクトルデータに変換することができます。また、それぞれの次元で取りうる数値の幅を制限することで、次元間の重要度の違いも表現することができます。
ベクトルデータに変換すると、類似関係をベクトル演算子で処理することが可能になります。
ベクトル空間の次元を大きくすれば、データ量は大きくなりますが、それだけ柔軟性の高い類似関係を扱うことができます。
エンベディングは、各単語を数百から数千次元のベクトルデータに変換します。
各次元の意味は大きさや色など人間に理解できる場合もありますが、コンピューターでしか理解できない場合もあります。どういう特徴が次元に選ばれるかはAIアプリケーションで行うエンベディング次第です。
エンベディングには単語単位の他に、LLMで使われている、 トークン単位や一定の長さの文章を丸ごとベクトルデータにエンベディングする方法もあります。どのエンベディングを使うかはAIアプリケーション次第となります。エンベディングにかかわらず、AIアプリケーションは最終的にベクトルデータを生成し、それをデータベースに保存して、ベクトルの演算処理をすることになるため、pgvector はAIアプリケーションと親和性が高いと言えます。
機械学習で作成されたベクトルデータをPowerGres データベースに登録してpgvector で扱う具体例を紹介します。
例としてFastText で作成された日本語の単語のベクトルデータのファイルをダウンロードして利用します。
FastText はFacebook 社(現Meta 社)が開発したテキスト表現やテキスト分類器を学習できるオープンソースで無料の軽量ライブラリです。
FastTextを用いてCommon CrawlとWikipediaで学習させた、157言語の事前学習済み単語ベクトルデータを配布しています。
これらの単語ベクトルデータは、CC BY-SA 3.0 ライセンスに基づいて配布されています。

提供元:
https://fasttext.cc/docs/en/crawl-vectors.html
ライセンス:
Creative Commons Attribution-ShareAlike 3.0 (CC BY-SA 3.0)
https://creativecommons.org/licenses/by-sa/3.0/
[postgres@rocky9 ~]$ mkdir /data/word2vec/
[postgres@rocky9 ~]$ cd /data/word2vec/
[postgres@rocky9 word2vec]$ curl -OL https://dl.fbaipublicfiles.com/fasttext/vectors-crawl/cc.ja.300.vec.gz
  % Total    % Received % Xferd  Average Speed   Time    Time     Time  Current
                                 Dload  Upload   Total   Spent    Left  Speed
100 1220M  100 1220M    0     0  1616k      0  0:12:53  0:12:53 --:--:-- 1658k
このファイルには日本語の単語が二百万件含まれています。ファイルサイズは1GB強ありました。
次に、ダウンロードしたファイルをPowerGresに登録するためにTSVファイルに変換します。TSVはタブ区切りのファイルで、単語とベクトルデータをタブで区切っています。タブ文字はダウンロードしたファイルに単語の一部として含まれていないため、区切り文字として扱いやすいです。変換はPython スクリプトで行いました。
TSVファイルサイズは4GB強になりました。
[postgres@rocky9 word2vec]$ cat mktsv.py
import gzip

INPUT_FILE = "cc.ja.300.vec.gz"
OUTPUT_FILE = "vectors.tsv"
LIMIT = 3000000

with gzip.open(INPUT_FILE, "rt", encoding="utf-8") as f, \
     open(OUTPUT_FILE, "w", encoding="utf-8") as out:
    # ヘッダ行スキップ
    next(f)
    for i, line in enumerate(f):
        if i >= LIMIT:
            break
        parts = line.rstrip().split()
        word = parts[0]
        vector = parts[1:]
        vec_str = "[" + ",".join(vector) + "]"
        out.write(f"{word}\t{vec_str}\n")
[postgres@rocky9 word2vec]$ python mktsv.py
[postgres@rocky9 word2vec]$ wc -l vectors.tsv
2000000 vectors.tsv
[postgres@rocky9 word2vec]
次にTSVファイルをPowerGres に登録します。
単語とベクトルデータを登録するテーブルを作成して、psql のメタコマンド\copy でそのテーブルに登録します。今回のベクトルデータは300次元なのでそれに合わせてテーブルを定義しています。\copy のオプションでCSV形式を指定し区切り文字をタブに変更し、二重引用符も単語の一部として含まれうるので、クォート文字はファイル内に存在しないバックスペースを指定しています。PowerGres のデータディレクトリは4GB弱になりました。
[postgres@rocky9 word2vec]$ /opt/powergres17/bin/psql -U testuser -d testdb
psql (17.9)
Type "help" for help.

testdb=> SET search_path = testschema, public;
SET
testdb=> CREATE TABLE word_embeddings (word text, embedding vector(300));
CREATE TABLE
testdb=> \copy word_embeddings(word, embedding) FROM '/data/word2vec/vectors.tsv' WITH (FORMAT csv, DELIMITER E'\t', QUOTE E'\b')
COPY 2000000
testdb=> SELECT COUNT(*) FROM word_embeddings;
  count
---------
 2000000
(1 row)

testdb=>
二百万件すべての単語とベクトルデータが登録されます。
次に、実際に単語を検索してみます。例えば「犬」に関連した単語を検索してみます。
「犬」単体のレコードが今回のデータセットに含まれているか確認してみます。SELECT文を実行すると「犬」という文字列と、エンベディングしたベクトルデータが確認できます。ベクトルデータは300次元となっています。
testdb=> SELECT * FROM word_embeddings WHERE word = '犬';
(略)
犬   | [-0.2146,-0.2391,0.072,0.1586,0.0262,0.2139,0.0414,0.1504,0.2698,0.2355,0.0339,0.0797,0.4562,0.065,-0.3562,-0.1534,-0.0898,0.1315,-0.2982,0.0327,0.1018,-0.1499,-0.3323,-0.069,0.0231,0.0225
,-0.0954,0.17,0.0996,0.1583,0.1552,-0.1448,-0.1736,-0.0798,0.0191,-0.0726,0.2581,-0.0582,0.17,(…以下同様の数値が並んでいるので省略。全部で300個となる)]
(1 row)

testdb=>
次に、「犬」に関連した単語を検索してみます。
データベースでの一般的な方法は、SELECT 文のLIKE 句で指定する方法です。
testdb=> SELECT word FROM word_embeddings WHERE word LIKE '%犬%' LIMIT 15;
  word
--------
 犬
 愛犬
 子犬
 柴犬
 犬山
 仔犬
 狂犬病
 飼い犬
 盲導犬
 負け犬
 狛犬
 犬飼
 野良犬
 猟犬
 番犬
(15 rows)

testdb=>
検索結果に「犬」が含まれている単語が出力されます。
今度は「犬」のベクトルデータに近い順に検索してみます。
距離はコサイン距離「」を指定します。
testdb=> SELECT word, embedding  (SELECT embedding FROM word_embeddings WHERE word = '犬') AS distance
FROM word_embeddings ORDER BY distance LIMIT 15;
     word     |      distance
--------------+---------------------
 犬           |                   0
 飼い犬       | 0.29386458644211555
 ワンコ       | 0.30949939025763584
 飼い主       |  0.3367078166695586
 愛犬         |  0.3394016673188782
 猫           |  0.3494613660216169
 子犬         | 0.34997457291011136
 仔犬         | 0.35545523543390556
 柴犬         |  0.3645315747019586
 ドーベルマン | 0.36693292505199593
 猟犬         |  0.3718109961648757
 しば犬       |  0.3724911956844441
 飼犬         |  0.3748259599879523
 チワワ       |  0.3870314058462826
 イヌ         |  0.3886612615445969
(15 rows)

testdb=>
「犬」という文字を含んでいませんが、ペットとして同様に人気のある「猫」、犬の「飼い主」、犬種の「ドーベルマン」なども出力されています。それぞれ異なる次元で「犬」に近いものが検索されているようです。この様にpgvector は検索条件の拡張という面が大きいと考えます。
せっかくなので、他の距離も利用してみましょう。
ユークリッド距離「」で近い順に並べると下記のようになります。
testdb=> SELECT word, embedding  (SELECT embedding FROM word_embeddings WHERE word = '犬') AS distance
testdb-> FROM word_embeddings ORDER BY distance LIMIT 15;
   word   |      distance
----------+--------------------
 犬       |                  0
 飼い犬   |  2.231316026410602
 ワンコ   |  2.267180546776844
 飼い主   |  2.317407915740561
 チワワ   |  2.418939694400773
 シェパ   | 2.4760773481387983
 日本犬   | 2.5087174063457893
 しば犬   | 2.5178094702848357
 ペット   | 2.5183102510186752
 シーズー | 2.5275031721961154
 猫板     | 2.5286251634302324
 コーギー |    2.5295275255294
 野良犬   |  2.530585778766946
 ケンネル |  2.535276436565103
 猫       | 2.5517584665314414
(15 rows)

testdb=>
他に、内積の符号を反転した値「」、マンハッタン距離「」なども利用できます。
作られるベクトルデータの品質や意味と適した距離は、「どんなAIアプリケーションで作ったか」「どんな文章で学習したか」等で決まります。
また、この例では実行速度を気にしていませんでした。速度が必要な場合はpgvector 用のインデックスが作成できます。
これまで見てきた通り、PowerGres のpgvector を利用することで、既存のデータベースにAIアプリケーションで作成したベクトルデータを、テーブルを作成してレコードとして登録することで利用できます。これはベクトルデータ用に別サーバーを用意して管理する必要がないということです。
また、SQLの拡張としてベクトル計算が利用できます。SQLに慣れていれば容易に利用でき、既存のテーブルと結合することで、関連付けて検索することが可能となります。
ぜひPowerGres でのpgvector の利用をご検討ください。


